
เช้าวันหนึ่งระบบหลังบ้านยังเปิดให้พนักงานขายทำงานได้ตามปกติ แต่เมื่อมีคำขอแก้สิทธิ์เร่งด่วน ไม่มีใครเข้าเมนูผู้ดูแลได้แล้ว แอดมินหลักเพิ่งลาออก บัญชีของเขาถูกปิดตามขั้นตอน และผู้ดูแลคนอื่นไม่มีสิทธิ์ระดับที่ใช้กู้ระบบ นี่ไม่ใช่แค่ปัญหาเรื่องรหัสผ่าน แต่เป็นจุดล้มเหลวเดียวของการดูแลระบบที่อาจทำให้งานธุรกิจหยุดชะงัก
วิธีลดความเสี่ยงคือเตรียม Break-glass Account หรือช่องทางเข้าถึงฉุกเฉินไว้ล่วงหน้า โดยองค์กรต้องควบคุมได้ว่าใครหยิบใช้ เมื่อไร ใช้เพื่อทำอะไร มีการแจ้งเตือนอย่างไร และเมื่อจบเหตุการณ์ตรวจย้อนกลับได้หรือไม่ ไม่ใช่สร้างบัญชี Admin อีกหนึ่งชื่อแล้วฝากรหัสไว้ในแชตกลุ่ม
ก่อนสร้างบัญชีสำรอง ให้เห็นเส้นทางสิทธิ์ของระบบจริง
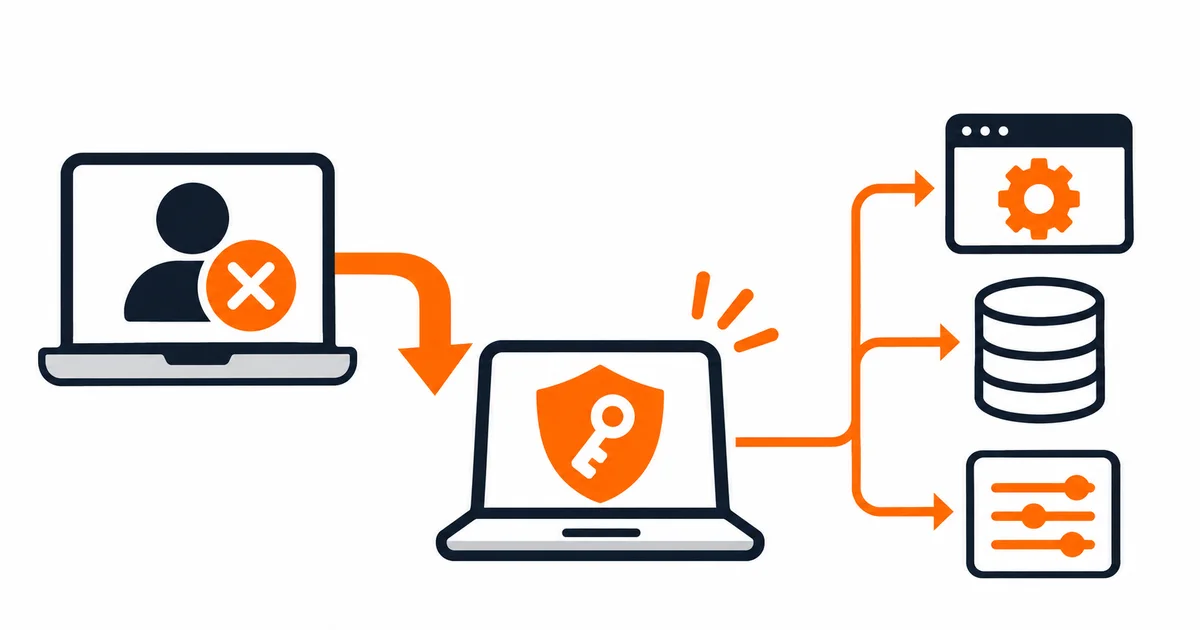
เริ่มจากวาดทางเดินหนึ่งเส้น: ผู้ดูแล → วิธีล็อกอิน (เช่น SSO/MFA) → ระบบจัดการตัวตน → บทบาทผู้ดูแล → Web App/ฐานข้อมูล/การตั้งค่าที่ต้องกู้ ถามว่าเมื่อแต่ละจุดล่มหรือผู้ถือสิทธิ์หายไป เราจะเข้าไปแก้ปัญหาจากอีกเส้นทางหนึ่งได้หรือไม่
ให้เจ้าของธุรกิจ ฝ่าย IT และเจ้าของระบบตรวจสี่คำถามร่วมกัน: (1) ใครมีสิทธิ์ Admin จริงในวันนี้ (2) ทุกคนต้องผ่าน IdP, MFA Device หรือเครือข่ายเดียวกันหรือเปล่า (3) ใครแก้นโยบายล็อกอินเมื่อทุกคนเข้าระบบไม่ได้ และ (4) ผู้ให้บริการมีช่องทางกู้คืนหรือ Support Escalation อย่างไร ถ้าตอบข้อใดไม่ได้ ให้จดเป็นความเสี่ยงก่อนแก้ค่าระบบ
ตัวอย่างสมมติ: บริษัทใช้ระบบคำสั่งซื้อภายใน โดย Admin สองคนล็อกอินผ่าน IdP เดียวกันและใช้เครื่องยืนยันตัวตนของทีม IT ถ้า IdP ใช้ไม่ได้ บัญชีสองชื่อก็อาจช่วยอะไรไม่ต่างจากบัญชีเดียว จุดสำคัญคือความเป็นอิสระของทางเข้าฉุกเฉิน ไม่ใช่เพียงจำนวนบัญชี
Break-glass Account ต่างจาก Admin ปกติและ Service Account อย่างไร
| ประเภท | งานหลัก | การใช้งานและหลักฐาน |
|---|---|---|
| Admin ปกติ | ดูแลระบบตามหน้าที่ประจำ | ใช้บัญชีเฉพาะบุคคล มีสิทธิ์ตามบทบาทและ Audit Log |
| Break-glass Account | กู้การดูแลระบบเมื่อเส้นทางปกติใช้ไม่ได้ | ไม่ใช้ทำงานประจำ คุมผู้ถือสิทธิ์ แจ้งเตือนทุกครั้ง และทบทวนหลังใช้ |
| Service Account | ให้โปรแกรมหรือ API ทำงานอัตโนมัติ | มีเจ้าของ Workload และรอบดูแล Credential ไม่ใช่ตัวแทนคนสำหรับเข้า Admin |
รายละเอียดการแบ่ง Role ก่อนพัฒนาระบบดูได้จาก แนวทางทำ Permission Matrix สำหรับระบบหลังบ้าน แต่บทนี้เน้นทางออกเมื่อการเข้าถึงแบบปกติใช้การไม่ได้แล้ว ส่วนการโอน Service Account หลังพนักงานลาออกเป็นอีกกระบวนการ ไม่ควรนำบัญชี Automation มาใช้ล็อกอินฉุกเฉินแทนบุคคล
Decision Gate: เมื่อไรจึงอนุญาตให้ใช้สิทธิ์ฉุกเฉิน
อย่าให้คำว่า “ด่วน” เป็นเหตุผลเดียวในการเปิดบัญชีสิทธิ์สูง แยกอย่างน้อยสามสถานการณ์และผู้ตัดสินใจให้ชัด
- ทางเข้าปกติยังใช้ได้: ให้ใช้บัญชี Admin ประจำผ่านระบบอนุมัติปกติ แม้งานจะเร่งด่วนก็ตาม
- ผู้ดูแลทั้งหมดถูกล็อก / ระบบตัวตนขัดข้อง: เจ้าของ Incident ตรวจหลักฐานการเข้าถึงล้มเหลวและอนุมัติการใช้ทางฉุกเฉินเฉพาะงานกู้ระบบ
- สงสัยบัญชีฉุกเฉินถูกยึดหรือ Log ผิดปกติ: ยกระดับเป็นเหตุความปลอดภัย ห้ามใช้งานต่อแบบไม่ตรวจสอบ และประสานผู้รับผิดชอบกู้คืนหรือผู้ให้บริการ
ข้อกำหนดควรบอกด้วยว่าใครแทนผู้อนุมัติได้ถ้าผู้อนุมัติคนแรกติดต่อไม่ได้ ต้องแจ้งใครก่อนเริ่ม และการกู้คืนขั้นต่ำที่ยอมรับได้คืออะไร เพื่อไม่ให้ขั้นตอนฉุกเฉินติดขัดเพราะขาดคนอนุมัติอีกชั้น
ออกแบบบัญชีสำรองให้พร้อมใช้โดยไม่เปิดช่องเสี่ยงใหม่
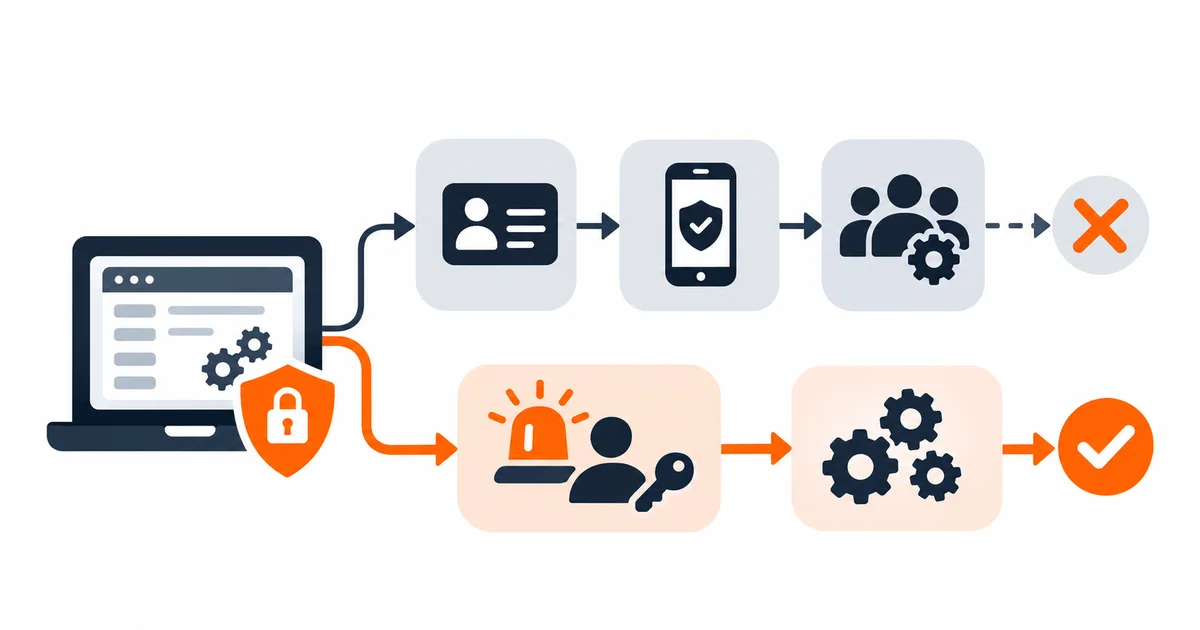
สำหรับ Microsoft Entra แนวทางของ Microsoft แนะนำบัญชีฉุกเฉินแบบ Cloud-only อย่างน้อยสองบัญชี แยกจากการพึ่งพา Federation ปกติ ใช้การยืนยันตัวตนที่แข็งแรงและมีจุดล้มเหลวต่างจาก Admin ประจำ พร้อมเฝ้าดู Sign-in และ Audit Log ทุกครั้งที่ถูกใช้ (Microsoft Learn: Emergency Access) นี่เป็นคำแนะนำเฉพาะแพลตฟอร์ม ไม่ใช่ข้อกำหนดว่า Web App ทุกตัวต้องสร้าง Global Administrator สองบัญชี
สำหรับ Web App ที่พัฒนาเอง ให้ทีมพัฒนาและผู้รับผิดชอบความปลอดภัยประเมินตามขีดความสามารถจริงของระบบ โดยกำหนดอย่างน้อยดังนี้
- Ownership: บัญชีเป็นทรัพย์สินขององค์กร ไม่ผูกกับอีเมลหรือโทรศัพท์ส่วนบุคคลของพนักงานที่อาจลาออก
- Independent recovery path: ทดสอบว่าในเหตุที่ต้องการกู้จริง เส้นทางฉุกเฉินยังผ่านการยืนยันตัวตนและการกำหนดสิทธิ์ได้ โดยไม่ต้องพึ่งบริการที่ล่ม
- Strong authentication: ไม่ปิด MFA เพียงเพราะอยากให้เข้าได้ง่าย เลือกวิธีที่ทนต่อฟิชชิงและมีการเก็บอุปกรณ์หรือข้อมูลรับรองอย่างปลอดภัยตามที่ระบบรองรับ
- Custody: จำกัดผู้รู้วิธีเบิกใช้ แยกสถานที่เก็บหรือผู้ถือครอง สำรองให้เข้าถึงได้เมื่อทีมหลักไม่อยู่ และทำรายการผู้รับผิดชอบที่ทบทวนได้
- Scope and audit: ใช้สิทธิ์เท่าที่การกู้ระบบจำเป็นและบันทึกว่าใครเป็นผู้ดำเนินการจริง หากแพลตฟอร์มต้องให้สิทธิ์สูงแบบถาวร ให้เสริมการแจ้งเตือนและการตรวจทานแทนการแสร้งว่ามี Least Privilege แล้ว
- Monitoring: ส่งแจ้งเตือนเมื่อมีการลงชื่อเข้าใช้หรือเปลี่ยนค่า ตั้งผู้รับแจ้งที่ไม่ต้องพึ่งช่องทางเดียวกับระบบที่อาจขัดข้อง
การแยกสิทธิ์ตามหน้าที่และตรวจการอนุญาตที่ฝั่งเซิร์ฟเวอร์เป็นหลักการจาก OWASP Authorization Cheat Sheet ไม่ใช่การแนะนำให้สร้างช่องทางข้ามการตรวจสิทธิ์ ถ้า Web App ปัจจุบันไม่มีความสามารถรองรับการกู้คืนอย่างปลอดภัย ให้ระบุเป็น Requirement เพื่อพัฒนาและทดสอบก่อนเปิดใช้จริง
ใบงานเตรียมความพร้อม: ใครรับผิดชอบและต้องพิสูจน์อะไร
| รายการ | ผู้รับผิดชอบหลัก | หลักฐานขั้นต่ำ |
|---|---|---|
| บัญชี/เส้นทางฉุกเฉินและ Dependency | System Owner + IT | ผังทางเข้าและรายการสิทธิ์ที่ตรวจจริง |
| เงื่อนไขเปิดใช้และผู้อนุมัติสำรอง | Business Owner | Incident Trigger, ผู้ตัดสินใจ, วิธีติดต่อ |
| ผู้เก็บรักษาข้อมูลรับรองและอุปกรณ์ | Security / Custodian | ทะเบียนผู้ถือครองและวิธีเบิกใช้ โดยไม่บันทึกรหัสลับลงใบงาน |
| Log และ Alert ที่แยกจากระบบหลัก | IT Operations | ตัวอย่างเหตุการณ์เตือนพร้อมเวลาที่ได้รับ |
| การทดสอบและตรวจรับ | ผู้ทดสอบ + ผู้ตรวจรับอีกคน | Test Case, ผล, วันเวลา, ปัญหา, ผู้ลงนาม |
ใบงานนี้เก็บเฉพาะตัวระบุบัญชีและหลักฐานที่จำเป็น ห้ามแปะรหัสผ่าน Recovery Code หรือ Secret ลงเอกสารรายงาน การเก็บข้อมูลลับต้องอยู่ในระบบหรือสถานที่ที่องค์กรอนุมัติแยกต่างหาก
ซ้อมกู้การเข้าถึงอย่างไรโดยไม่ทำให้ระบบจริงเสียหาย
การสร้างบัญชีแล้วไม่เคยทดสอบอาจทำให้รู้ว่ากู้ไม่ได้ในวันที่เกิดเหตุจริง กำหนดรอบซ้อมเป็นงาน Operation โดยมีขอบเขตชัด ใช้บัญชีทดสอบกับงานอ่านค่าหรือการตรวจการเข้าถึงเมนูที่ปลอดภัยก่อน ไม่ควรจงใจปิด IdP หรือถอดสิทธิ์ Admin ทั้งหมดใน Production เพื่อพิสูจน์แผน
- ก่อนซ้อม: แจ้งผู้ตรวจจับเหตุให้ทราบว่าเป็น Drill ระบุ Change/Incident ID เวลาที่เริ่ม สิทธิ์และรายการคำสั่งที่อนุญาต
- ระหว่างซ้อม: ผู้รับผิดชอบเปิดช่องทางฉุกเฉินตามขั้นตอนที่อนุมัติ พิสูจน์การลงชื่อเข้าใช้และอ่านสถานะสิทธิ์ โดยไม่แก้ข้อมูลลูกค้าหรือข้ามนโยบายความปลอดภัย
- ตรวจ Alert: ทีม Monitoring ต้องเห็นเหตุการณ์ Sign-in และส่งสัญญาณไปยังผู้รับแจ้งที่กำหนด พร้อมตรวจ Timestamp และตัวระบุเหตุการณ์
- หลังซ้อม: ออกจากระบบ ปิด Session ที่เกี่ยวข้องตามความสามารถแพลตฟอร์ม ตรวจว่า Admin ปกติยังทำงานได้ และผู้ตรวจรับลงนามว่าผลตรงกับ Test Case
Microsoft แนะนำการตรวจบัญชีฉุกเฉิน Microsoft Entra อย่างน้อยทุก 90 วัน พร้อมทดสอบการใช้งานและการแจ้งเตือน (Microsoft Learn) สำหรับระบบอื่นให้กำหนดความถี่จากระดับความเสี่ยง ข้อบังคับ และการเปลี่ยนคนหรือระบบ ไม่คัดลอกตัวเลขโดยไม่ดูบริบท
เมื่อเกิดเหตุจริง: Runbook 6 ช่วงที่คนในองค์กรต้องทำตามได้
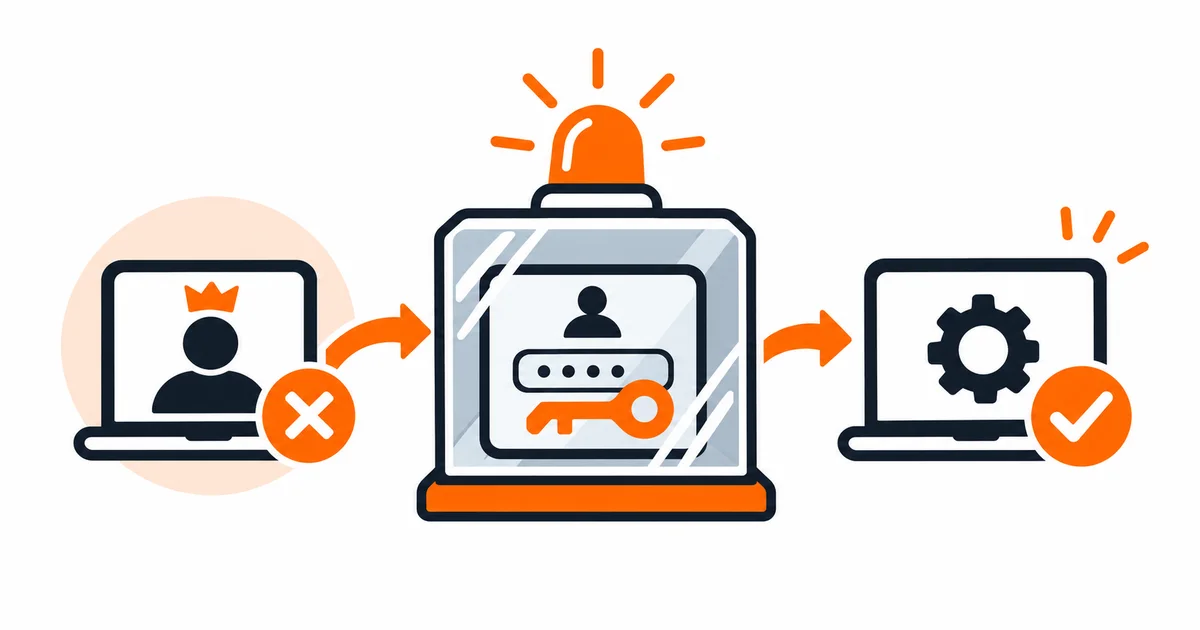
- ประกาศเหตุ: เปิด Incident Record ระบุระบบที่เข้าไม่ได้ อาการ เวลา ผลกระทบ และผู้ประสานงาน
- ยืนยันเหตุและอนุมัติ: ตรวจว่าช่องทาง Admin ปกติใช้ไม่ได้จริง ผู้อนุมัติหรือผู้แทนอนุมัติการกู้ตามเงื่อนไข
- เบิกใช้แบบมีผู้รับผิดชอบ: ผู้ถือครองนำบัญชีฉุกเฉินมาใช้จากอุปกรณ์ปลอดภัยตามขั้นตอน ไม่แชร์รหัสในแชต
- ทำเฉพาะงานกู้: คืนสิทธิ์ให้ผู้ดูแลที่ได้รับอนุญาต แก้การกำหนดค่าที่ทำให้ล็อกระบบ หรือประสานผู้ให้บริการ โดยบันทึกการเปลี่ยนค่าและผู้ทำ
- ตรวจผลธุรกิจ: ยืนยันว่าทีมปกติกลับเข้าใช้งานได้ งานสำคัญไม่เสียหาย และ Monitoring ทำงานอยู่
- ปิดและทบทวน: สิ้นสุดการใช้ฉุกเฉิน ตรวจ Log/Session/Alert/การเปลี่ยนสิทธิ์ รวบรวมหลักฐานและกำหนดงานป้องกันไม่ให้เกิดซ้ำ
หากกู้ไม่ได้ ให้ใช้ช่องทาง Support หรือ Recovery ที่ระบุไว้ในแผน ไม่ทดลองหลบระบบยืนยันตัวตนหรือดัดแปลงฐานข้อมูลสิทธิ์โดยไม่มีผู้รับผิดชอบและการตรวจความเสี่ยง
หลักฐานปิดเหตุการณ์ต้องตอบได้ว่าใครทำอะไร และสิทธิ์กลับมาปลอดภัยหรือยัง
เมื่อกู้คืนการเข้าถึงได้แล้ว ให้ผู้ตรวจรับที่ไม่ได้เป็นผู้ทำการแก้ไขทั้งหมด ตรวจอย่างน้อยห้ารายการ: (1) ผู้อนุมัติและเหตุที่เปิดใช้ (2) ช่วงเวลาลงชื่อเข้าใช้และ Session ที่เกี่ยวข้อง (3) การเปลี่ยน Role/นโยบาย/บัญชีที่เกิดขึ้น (4) หลักฐานแจ้งเตือนและการกลับมาทำงานของระบบ และ (5) ผู้รับผิดชอบปิดงานแก้สาเหตุถาวร
หากไม่ทราบว่าใครใช้บัญชีร่วมกันจริง ต้องบันทึกข้อจำกัดของหลักฐานอย่างตรงไปตรงมาและพิจารณาปรับ Custody ก่อนซ้อมครั้งหน้า หากพบการใช้โดยไม่ได้อนุญาตให้เปิด Incident ความปลอดภัยแยก ไม่ทำเพียงปิด Ticket ตามปกติ Microsoft แนะนำการตรวจ Sign-in/Audit Log และทำ Post-mortem ทุกครั้งที่มีการใช้ Emergency Account (Microsoft: Privileged Account Monitoring)
ก่อนระบบใหม่เปิดใช้จริง ควรนำ Runbook และการซ้อมนี้ไปรวมใน Deployment Readiness ของ Web App เพื่อไม่ให้แผนกู้ระบบกลายเป็นเอกสารที่ไม่มีใครเคยทดลอง ส่วนธุรกิจที่ต้องออกแบบเส้นทางดูแลระบบและสิทธิ์ตั้งแต่ต้น สามารถใช้ บริการพัฒนา Web App และระบบหลังบ้าน เป็นจุดเริ่มต้นในการกำหนด Requirement กับทีมพัฒนา
แหล่งอ้างอิง
- Microsoft Learn — Manage emergency access admin accounts in Microsoft Entra ID (ตรวจสอบ 12 พฤศจิกายน 2569)
- Microsoft Learn — Security operations for privileged accounts in Microsoft Entra ID (ตรวจสอบ 12 พฤศจิกายน 2569)
- OWASP — Authorization Cheat Sheet (ตรวจสอบ 12 พฤศจิกายน 2569)
หมายเหตุ: ตัวอย่างใบงานและ Runbook ในบทความเป็นกรอบออกแบบการปฏิบัติงาน ไม่ใช่ผลทดสอบระบบของลูกค้าจริง และการตั้งค่าบัญชีฉุกเฉินต้องปรับตามแพลตฟอร์มและนโยบายองค์กร
คำถามที่พบบ่อยเกี่ยวกับ บัญชีแอดมินฉุกเฉิน Web App
Break-glass Account จำเป็นสำหรับ Web App ทุกระบบหรือไม่?
ไม่จำเป็นต้องใช้ชื่อหรือฟีเจอร์เดียวกันทุกระบบ แต่ระบบที่ธุรกิจพึ่งพาและเสี่ยงสูญเสียผู้ดูแลทั้งหมดควรมีเส้นทางกู้การเข้าถึงที่ทดสอบได้ หากผู้ให้บริการไม่รองรับบัญชีสำรอง ต้องมีขั้นตอนกู้คืนกับเจ้าของแพลตฟอร์มหรือผู้ให้บริการที่ชัดเจน
ใช้บัญชีแอดมินของพนักงานที่ลาออกเป็นบัญชีฉุกเฉินต่อได้ไหม?
ไม่ควร เพราะทำให้ความรับผิดชอบและหลักฐานว่าใครใช้บัญชีไม่ชัด ควรใช้ตัวตนฉุกเฉินที่องค์กรเป็นเจ้าของ แยกจากบัญชีบุคคล และถอนสิทธิ์บุคคลเดิมตามกระบวนการ
บัญชีฉุกเฉินต้องปิด MFA เพื่อให้เข้าระบบได้เสมอหรือไม่?
ไม่ควรถือว่าการปิด MFA เป็นค่าเริ่มต้น ต้องเลือกวิธียืนยันตัวตนที่รัดกุมและไม่พึ่งจุดล้มเหลวเดียวกับบัญชีปกติ เช่น วิธีแบบทนต่อฟิชชิงที่แพลตฟอร์มรองรับ พร้อมตรวจเงื่อนไขการเข้าถึงจริง
ควรทดสอบ Break-glass Account บ่อยแค่ไหน?
กำหนดรอบตามความสำคัญของระบบและข้อกำหนดองค์กร สำหรับ Microsoft Entra มีแนวทางให้ตรวจสอบอย่างน้อยทุก 90 วัน แต่ไม่ควรนำตัวเลขนี้ไปอ้างเป็นข้อบังคับสำหรับทุก Web App; ทุกครั้งควรบันทึกผลการเข้าสู่ระบบ การแจ้งเตือน และผู้ตรวจรับ
ถ้ามีการใช้บัญชีฉุกเฉินโดยไม่มีใบอนุมัติควรทำอย่างไร?
ถือเป็นเหตุที่ต้องตรวจสอบทันที รักษา Log และหลักฐาน แจ้งทีมความปลอดภัย ตรวจขอบเขตการกระทำและสิทธิ์ที่เปลี่ยน ก่อนตัดสินใจหมุนเวียนข้อมูลรับรองหรือระงับบัญชีโดยไม่ทำให้ช่องทางกู้คืนทั้งหมดสูญหาย
ดูขอบเขตบริการที่เกี่ยวข้อง วิธีทำงาน และข้อมูลที่ควรเตรียมก่อนให้ทีมประเมิน
ดูบริการที่เกี่ยวข้องส่งรายละเอียดงานให้ทีมประเมิน
กรอกชื่อ เบอร์โทร และรายละเอียดที่อยากให้ช่วย ทีมจะติดต่อกลับเพื่อประเมินแนวทาง